github.com
Spark is a fast and general engine for large-scale data processing.
Directory
Published directory entries matching your search.
Spark is a fast and general engine for large-scale data processing.
Analyzes structured data and helps produce queries, insights or visualizations.
A data exploration platform designed to be visual, intuitive, and interactive.
Workflow tool to automatically organize data visualization output.
A data and concept drift library for PyTorch.
Enriches training datasets with features from public and community shared data sources.
Minimalist neural network library optimized for sparse data and single machine environments.
Cheminfo - Platform for data visualization and analysis, using the project.
AI evaluation platform for interactively exploring data and model outputs.
openserp tracks rankings, SERP visibility, and keyword performance across search results.
OpenZeppelin is a developer security tool for smart contracts, testing, monitoring, or audits.
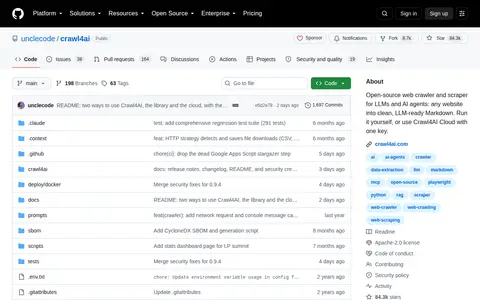
Open source web crawler built for extracting clean website data for AI and LLM workflows.
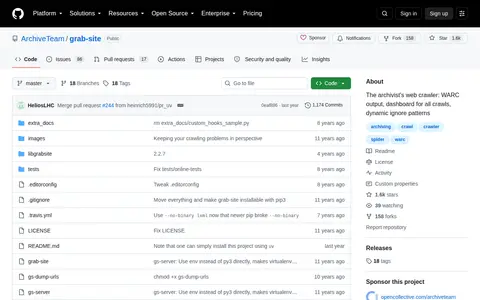
grab-site is an open source web scraping or crawling project for collecting website data.
Open source video stabilization tool using gyro data for smooth action-camera footage.
LaravelMetaTags helps manage meta tags, Open Graph data, and social sharing previews for websites.
nextjs-headless-wordpress helps manage meta tags, Open Graph data, and social sharing previews for websites.
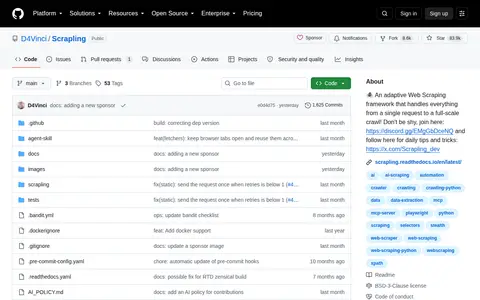
Scrapling is an open source web scraping or crawling project for collecting website data.
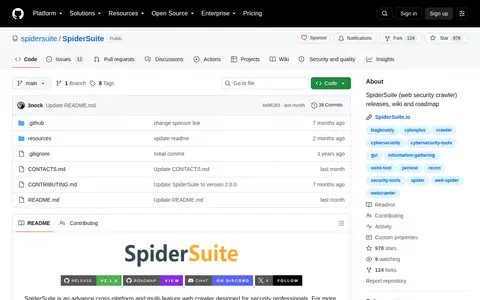
Spider Suite is an open source web scraping or crawling project for collecting website data.
svelte-meta-tags helps manage meta tags, Open Graph data, and social sharing previews for websites.
svelte-seo helps manage meta tags, Open Graph data, and social sharing previews for websites.
GitHub collection of APT reports, threat actor notes, and security research documents.
Exploit-DB paper archive with security research, exploitation papers, and technical writeups.
Source code and experiments results for 2018 Data Science Bowl.
schema-org helps create or test structured data, schema markup, and rich-result eligibility.